Gemini 4 Neon: Google encosta no Opus 5.5 e corta 25% do preço da API
A família Gemini ganhou um filho do meio — e ele chegou com aquela autoestima de quem entra na sala dizendo: “Não sou o mais caro, mas posso fazer quase o mesmo trabalho.”
O nome do novo integrante é Gemini 4 Neon. A Google lançou o modelo em 18 de novembro com uma proposta bem clara: entregar desempenho de ponta em programação, análise e tarefas científicas, mas com velocidade e preço mais comportados que os modelos gigantes da categoria.
A provocação veio rápido: o Neon aparece em comparações com o Claude Opus 5.5, da Anthropic, como um modelo de desempenho semelhante em tarefas de codificação — só que com preço de API 25% menor que o valor padrão do rival.
Mas calma. “Equivalente” em inteligência artificial é uma palavra que precisa de lupa, marca-texto e talvez uma testemunha. Os resultados mudam conforme o benchmark, o nível de raciocínio e o agente usado para executar a tarefa.

O que o Gemini 4 Neon traz?
O Neon ocupa a faixa intermediária da família Gemini 4:
- o Hydrogen fica como opção mais leve e rápida para tarefas do dia a dia;
- o Neon mira programação complexa, análise e trabalho agentivo;
- o Carbon continua voltado para os projetos mais difíceis e longos.
Na prática, o Neon tenta ser aquele modelo que você deixa trabalhando em um repositório grande, uma pilha de documentos ou uma análise cheia de etapas sem ele perder o fio da meada no terceiro parágrafo.
Ele oferece uma janela de contexto unificada de 1 milhão de tokens. Isso significa que pode trabalhar com uma quantidade enorme de texto, código e outros dados no mesmo contexto — embora “caber” não signifique automaticamente “entender tudo perfeitamente”, porque até inteligência artificial precisa de organização.
O modelo também aceita entradas de texto, imagem, vídeo e áudio, com saída em texto. Para o usuário comum, isso significa poder misturar documentos, planilhas, imagens e explicações numa mesma tarefa, em vez de converter tudo para um formato só antes de começar.
Quatro níveis de raciocínio
O Gemini 4 Neon tem quatro níveis de esforço:
low— menos tokens e menor latência;medium— respostas mais rápidas para tarefas interativas;high— nível padrão, equilibrando qualidade e velocidade;xhigh— raciocínio mais profundo para problemas difíceis.
Esse controle é importante porque raciocínio custa tempo e tokens. Nem toda pergunta precisa do modelo encarando o vazio por três minutos antes de responder qual é a fórmula do Excel.
Para uma conversa simples, low ou medium pode bastar. Para refatorar um sistema inteiro, investigar um bug difícil ou analisar um conjunto enorme de documentos, o high ou xhigh entra em campo.
A documentação da Google também informa que o Neon suporta respostas longas, com execução em segundo plano ou continuação do lado do cliente quando a tarefa ultrapassa o limite de uma resposta síncrona comum.
E o tal desempenho de codificação no nível do Opus?
Aqui mora o detalhe mais interessante — e também a parte em que a manchete pode correr mais que o benchmark.
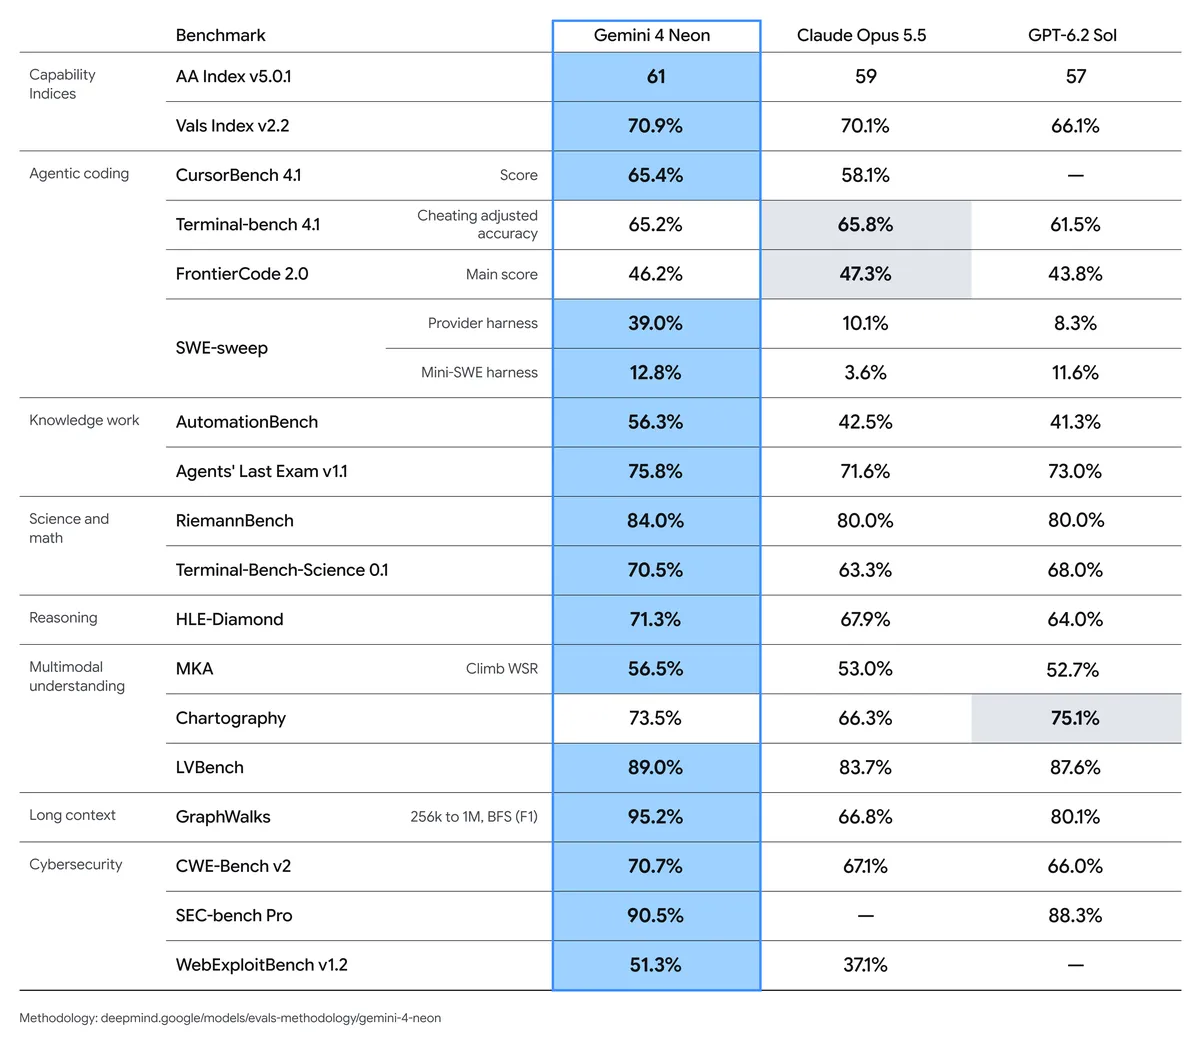
No FrontierCode 2.0, a Google reporta 46,2% para o Gemini 4 Neon, enquanto o Claude Opus 5.5 aparece com 47,3% na comparação citada. A diferença é de 1,1 ponto percentual. Isso coloca os modelos na mesma conversa, mas não autoriza dizer que são exatamente iguais em todo tipo de programação.
No Terminal-Bench 4.1, o Neon alcançou 65,2% segundo a Google. A empresa também informa que o modelo ficou em primeiro lugar no Artificial Analysis Coding Agent Index, com 58,6 no resultado divulgado no anúncio.
Existe ainda um detalhe que muda tudo: o software ao redor do modelo. No teste SWE-sweep, a Google reporta 12,8% usando o mini-SWE harness e 39% usando o Google Antigravity. Ou seja, não é apenas “qual modelo respondeu melhor?”. Também importa qual agente lê os arquivos, executa comandos, revisa o diff, repete tentativas e organiza a tarefa.
É como comparar dois cozinheiros dando a mesma nota, mas um deles recebeu uma cozinha completa e o outro ganhou apenas uma panela. O ingrediente importa. O ambiente também.
A conta: 25% mais barata que o Opus 5.5
O preço oficial do Gemini 4 Neon na API é:
- US$ 3 por 1 milhão de tokens de entrada;
- US$ 15 por 1 milhão de tokens de saída;
- US$ 0,15 por 1 milhão de tokens de entrada em cache, com desconto de 95%.
O Claude Opus 5.5 aparece com preço padrão de US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída. É daí que vem a conta dos 25% de diferença.
Só que o Neon não é o modelo mais barato da praça. O Claude Sonnet 5.5 e o GPT-6.2 Sol, por exemplo, aparecem com preços padrão menores na comparação da VentureBeat. Portanto, a proposta não é “o mais barato de todos”. É oferecer desempenho próximo de modelos maiores gastando menos por token.
E tem uma pegadinha de calendário: o Gemini 4 Carbon está com preço promocional de US$ 2 por milhão de tokens de entrada e US$ 10 de saída até 30 de novembro. A partir de 1º de dezembro, o preço padrão do Carbon sobe para US$ 4 e US$ 20. A partir daí, o Neon fica 25% abaixo do irmão maior.
Ou seja: a planilha de preços tem data de validade. Tecnologia adora um asterisco.
Onde ele já está disponível?
O Gemini 4 Neon começou a ser liberado em:
- Gemini API, no plano pago do Google AI Studio;
- Gemini for business, via API e seletor de modelos;
- Google Antigravity, para assinantes Google AI Pro e Ultra;
- aplicativo Gemini, para assinantes Pro e Ultra;
- Android Studio, conforme a disponibilidade indicada pela Google.
O identificador do modelo para uso na API é:
gemini-4-neon
Um ponto importante: o Neon está disponível apenas no nível pago da API. O fato de ele aparecer no Google AI Studio não significa que todo uso será gratuito.
Vale trocar de modelo agora?
Para quem programa, trabalha com agentes ou lida com documentos longos, o Neon merece um teste controlado. A combinação de contexto de 1 milhão de tokens, níveis de raciocínio e preço abaixo do Opus 5.5 pode ser interessante para tarefas frequentes que exigem mais do que um modelo rápido, mas não justificam sempre o modelo mais caro.
Eu faria três testes antes de migrar qualquer sistema:
- rodaria o mesmo conjunto de tarefas no Neon, no modelo atual e no concorrente;
- mediria qualidade, tempo, quantidade de tokens e custo total;
- conferiria se o modelo realmente edita, testa e revisa o código — não apenas produz uma resposta bonita.
Porque o modelo que vence no anúncio pode não ser o que vence no seu repositório, com seus arquivos, suas dependências e aquele bug antigo que ninguém quer assumir.
O Gemini 4 Neon parece uma jogada esperta da Google: colocar desempenho de fronteira numa faixa mais rápida e mais barata, pressionando tanto o Opus quanto os próprios modelos da casa. A pergunta não é mais só “qual IA é mais inteligente?”. Agora também é: qual delas entrega o resultado certo sem fazer a conta da API virar um segundo problema?
Fontes consultadas
- Anúncio oficial do Gemini 4 Neon — Google
- Documentação oficial do Gemini 4 Neon no Google AI Studio
- Preços dos modelos Gemini — Google AI Studio
- Análise da Artificial Analysis sobre o Gemini 4 Neon
- Reportagem da VentureBeat
A Google anunciou o Neon. Agora começa a parte menos glamourosa e mais útil: colocar o modelo pra trabalhar, medir a conta e descobrir se ele é brilhante mesmo ou só fez uma entrada de gala na apresentação. 😅
Se este post te ajudou a entender o novo modelo, você pode mandar uma mensagem via Pix para pix@gean.me. É opcional, qualquer valor é bem-vindo e você pode escrever um recado junto da transferência; as melhores mensagens podem aparecer nas próximas edições, sem promessa de publicação garantida. A IA ganhou um modelo novo, e a redação continua negociando com a fatura do servidor. 😂