Nvidia monta um ‘supercomputador de mesa’ com quatro DGX Spark e 512 GB de memória
A Nvidia olhou para a fila de espera dos supercomputadores e parece ter pensado: “E se a gente colocasse uma pequena sala de pesquisa em cima da mesa?”
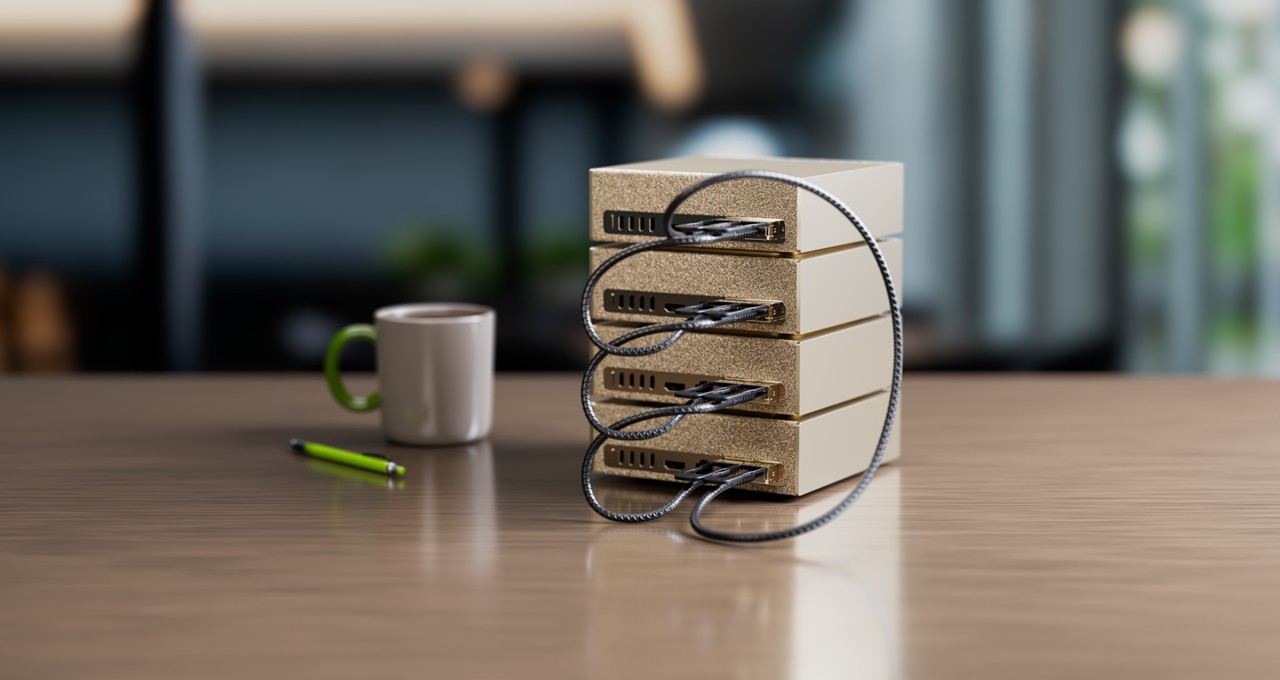
Foi assim que apareceu o DGX Spark HPC Developer Kit, um conjunto que conecta quatro unidades do DGX Spark para formar uma espécie de laboratório de computação de alto desempenho de tamanho… digamos, menos assustador que um data center inteiro.
O número que chamou atenção foi 512 GB de memória combinada. Mas já vamos tirar a primeira confusão da mesa: não é uma única caixinha com 512 GB de RAM. São quatro computadores, cada um com 128 GB, trabalhando juntos.
Quatro mini computadores fazendo reunião de condomínio
O kit foi apresentado pela Nvidia durante a conferência de supercomputação SC26, em Chicago, nos Estados Unidos. A proposta é levar para pesquisadores, universidades e desenvolvedores uma estrutura local para testar modelos de inteligência artificial e aplicações científicas.
Cada DGX Spark usa o GB10 Grace Blackwell, um superchip que combina uma CPU Arm de 20 núcleos com uma GPU baseada na arquitetura Blackwell. A Nvidia informa até 1 petaflop de desempenho em FP4, uma precisão numérica usada em cargas de trabalho de IA.
As quatro máquinas são conectadas por rede ConnectX-7 e podem funcionar como um conjunto distribuído. Segundo a Nvidia, a configuração em anel permite ligar cada unidade às vizinhas diretamente, sem depender de um switch de rede separado para começar o trabalho.
Traduzindo: em vez de comprar uma máquina monstruosa, a equipe conecta quatro máquinas menores e distribui o serviço entre elas. É como transformar quatro notebooks muito musculosos em uma equipe de revezamento — só que sem ninguém pedir intervalo para tomar café.
O que dá para fazer com 512 GB?
A Nvidia diz que o conjunto consegue executar localmente modelos de IA com até 700 bilhões de parâmetros, usando o formato NVFP4 para reduzir o consumo de memória.
Essa frase precisa de contexto. “Executar um modelo” não é a mesma coisa que treinar do zero um modelo desse tamanho em velocidade industrial. A configuração pode ser usada para inferência, testes, protótipos e distribuição de cargas entre os nós. O resultado real depende do modelo, da quantização, da forma como o software divide o trabalho e da memória necessária para cada etapa.
Mesmo assim, é uma mudança interessante. Um pesquisador pode testar uma arquitetura, um agente ou um fluxo de inferência sem mandar cada experimento para a nuvem ou esperar uma vaga em um cluster compartilhado.
A Nvidia cita aplicações como:
- execução e avaliação de modelos de IA;
- agentes que preparam simulações e resumem resultados;
- simulações de materiais;
- dinâmica molecular;
- desenvolvimento de aplicações científicas com C, C++ e Fortran;
- testes de comunicação entre várias GPUs antes de migrar para um supercomputador maior.
Entre os exemplos mencionados pela empresa aparecem LAMMPS, usado em simulações de materiais, e NAMD, voltado a dinâmica molecular. A ideia é permitir que a equipe faça o desenvolvimento e a depuração localmente antes de ocupar recursos de uma infraestrutura de produção.
Não é só sobre IA generativa
A primeira reação ao ver 512 GB e Blackwell é pensar em chatbot, geração de vídeo e código automático. Só que o projeto mira também a computação científica tradicional.
Um laboratório pode usar o cluster para preparar entradas de simulação, testar como os dados são distribuídos entre os nós e encontrar problemas de comunicação antes de enviar o trabalho para uma estrutura maior.
Isso tem um impacto prático importante. Em muitos centros de pesquisa, o gargalo não é apenas o preço do hardware. É o tempo de espera por uma fila compartilhada, a disputa por GPU e a dificuldade de reproduzir um experimento no mesmo ambiente em que ele foi desenvolvido.
Ter uma máquina local não elimina a necessidade de supercomputadores. Mas pode reduzir a quantidade de trabalho preliminar que precisa disputar espaço com tarefas de produção.
O detalhe da capacidade de armazenamento
Aqui há um pequeno B.O. de especificação que merece ser registrado.
O Tecnoblog informa 20 TB de armazenamento NVMe para o conjunto. Já o anúncio oficial da Nvidia sobre o kit fala em 16 TB de NVMe, e a página do DGX Spark informa até 4 TB por unidade. Quatro máquinas com 4 TB cada chegam a 16 TB.
Por isso, neste post, tratamos os 16 TB como o número sustentado pela fonte oficial da Nvidia. O valor de 20 TB aparece na reportagem do Tecnoblog, mas não bate com a soma publicada pela fabricante. Pode haver diferença de configuração, arredondamento ou erro de especificação — e esse pedaço ainda não fecha com segurança.
É justamente por isso que ficha técnica merece leitura completa, e não apenas um “uau” na manchete.
Quanto custa esse supercomputador de mesa?
A Nvidia informou que o kit está disponível para compra por meio de parceiros, mas não divulgou o preço do conjunto de quatro máquinas.
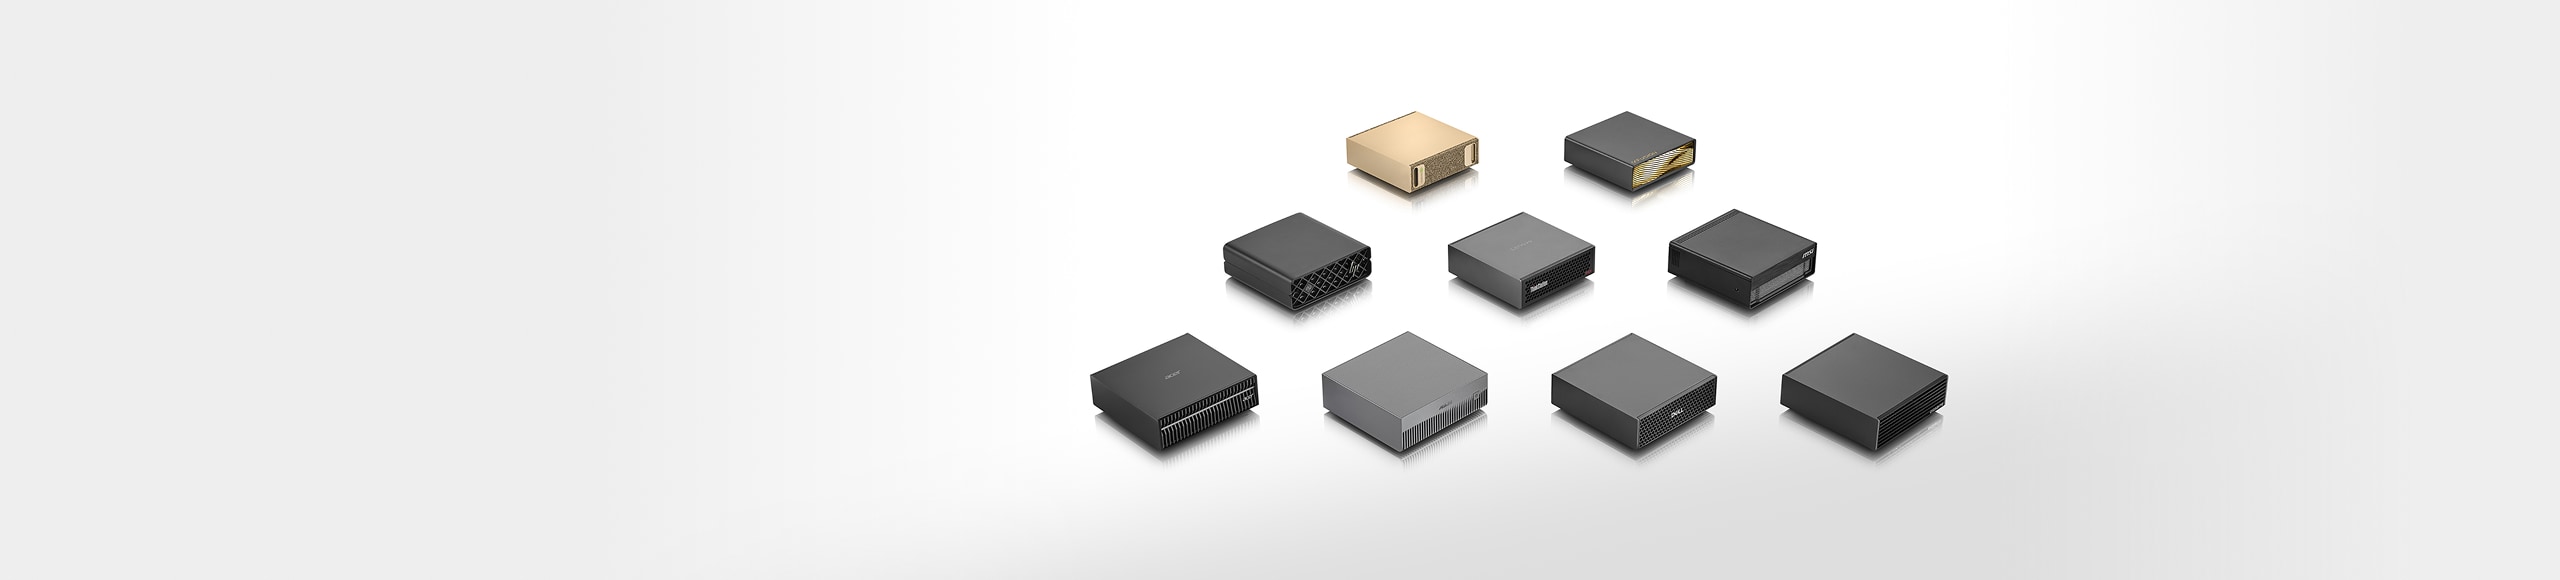
Entre os fabricantes e parceiros citados estão Acer, ASUS, Dell Technologies, GIGABYTE, H3C, HP, Lenovo, MSI e xFusion. Também é possível encontrar unidades individuais e cabos pelo marketplace da Nvidia, dependendo da região.
E aqui mora a parte que impede qualquer empolgação com a palavra “desktop”. Desktop, nesse caso, não significa computador barato para colocar ao lado do monitor e abrir o navegador. São quatro sistemas com hardware especializado, rede de alta velocidade, consumo elétrico, refrigeração e software de computação científica.
É de mesa, sim. Mas não é exatamente um PC gamer que você parcela em 24 vezes para jogar o próximo lançamento.
A Nvidia quer tirar a IA da nuvem?
Não exatamente. A estratégia parece mais sofisticada do que uma simples disputa entre “local” e “nuvem”.
A empresa quer oferecer uma etapa intermediária: o pesquisador desenvolve, testa e depura localmente; depois, quando a carga cresce, leva o trabalho para um supercomputador ou data center acelerado.
Esse modelo pode ajudar em projetos que lidam com dados sensíveis, resultados ainda não publicados ou conjuntos que uma equipe prefere manter dentro da própria infraestrutura. Também permite testar agentes e modelos sem pagar por cada experimento em uma API externa — embora o investimento inicial em hardware seja bem mais salgado.
A conta muda de lugar. Sai parte do gasto recorrente com nuvem e entra um investimento alto em equipamento, energia, manutenção e equipe especializada. Não existe almoço grátis; existe, no máximo, uma fatura com outro formato.
Por que isso importa?
O DGX Spark HPC Developer Kit mostra uma tendência que está ficando cada vez mais clara: a computação de IA está descendo do data center para laboratórios, empresas e, em alguns casos, mesas de trabalho.
A diferença é que agora não estamos falando apenas de rodar um modelo pequeno no notebook. Estamos falando de montar pequenos clusters locais capazes de testar modelos enormes, agentes e simulações científicas com mais controle sobre os dados e o ambiente.
Ainda não dá para chamar o kit de substituto de um supercomputador tradicional. Ele é uma plataforma de desenvolvimento e experimentação, não uma varinha mágica para transformar qualquer escritório em uma instalação da NASA.
Mas a ideia é poderosa: antes de entrar na fila do supercomputador, o pesquisador pode fazer boa parte do trabalho em casa — ou, pelo menos, na sala ao lado.
A Nvidia está vendendo hardware. Mas o que ela realmente está tentando vender é tempo de pesquisa. E, nesse mercado, não precisar esperar dias por uma vaga de GPU pode valer tanto quanto alguns terabytes a mais na ficha técnica.
Fontes consultadas
- Reportagem do Tecnoblog
- Anúncio oficial do NVIDIA DGX Spark HPC Developer Kit
- Página oficial do NVIDIA DGX Spark
- NVIDIA Marketplace
A Nvidia colocou um pequeno pedaço do data center sobre a mesa. Agora falta descobrir se o orçamento da pesquisa também cabe nela. 😅
Se esta explicação te ajudou a entender o novo kit, você pode mandar uma mensagem via Pix para pix@gean.me. É opcional, qualquer valor é bem-vindo e você pode escrever um recado junto da transferência; as melhores mensagens podem aparecer nas próximas edições, sem promessa de publicação garantida. A redação aceita carinho, café e contribuições para não precisar instalar quatro servidores na sala. 😂